Debian 11 po ukończeniu wsparcia: apt-get upgrade kontra rootkit (404 i czego sie z tego nauczylem)
2026-11-05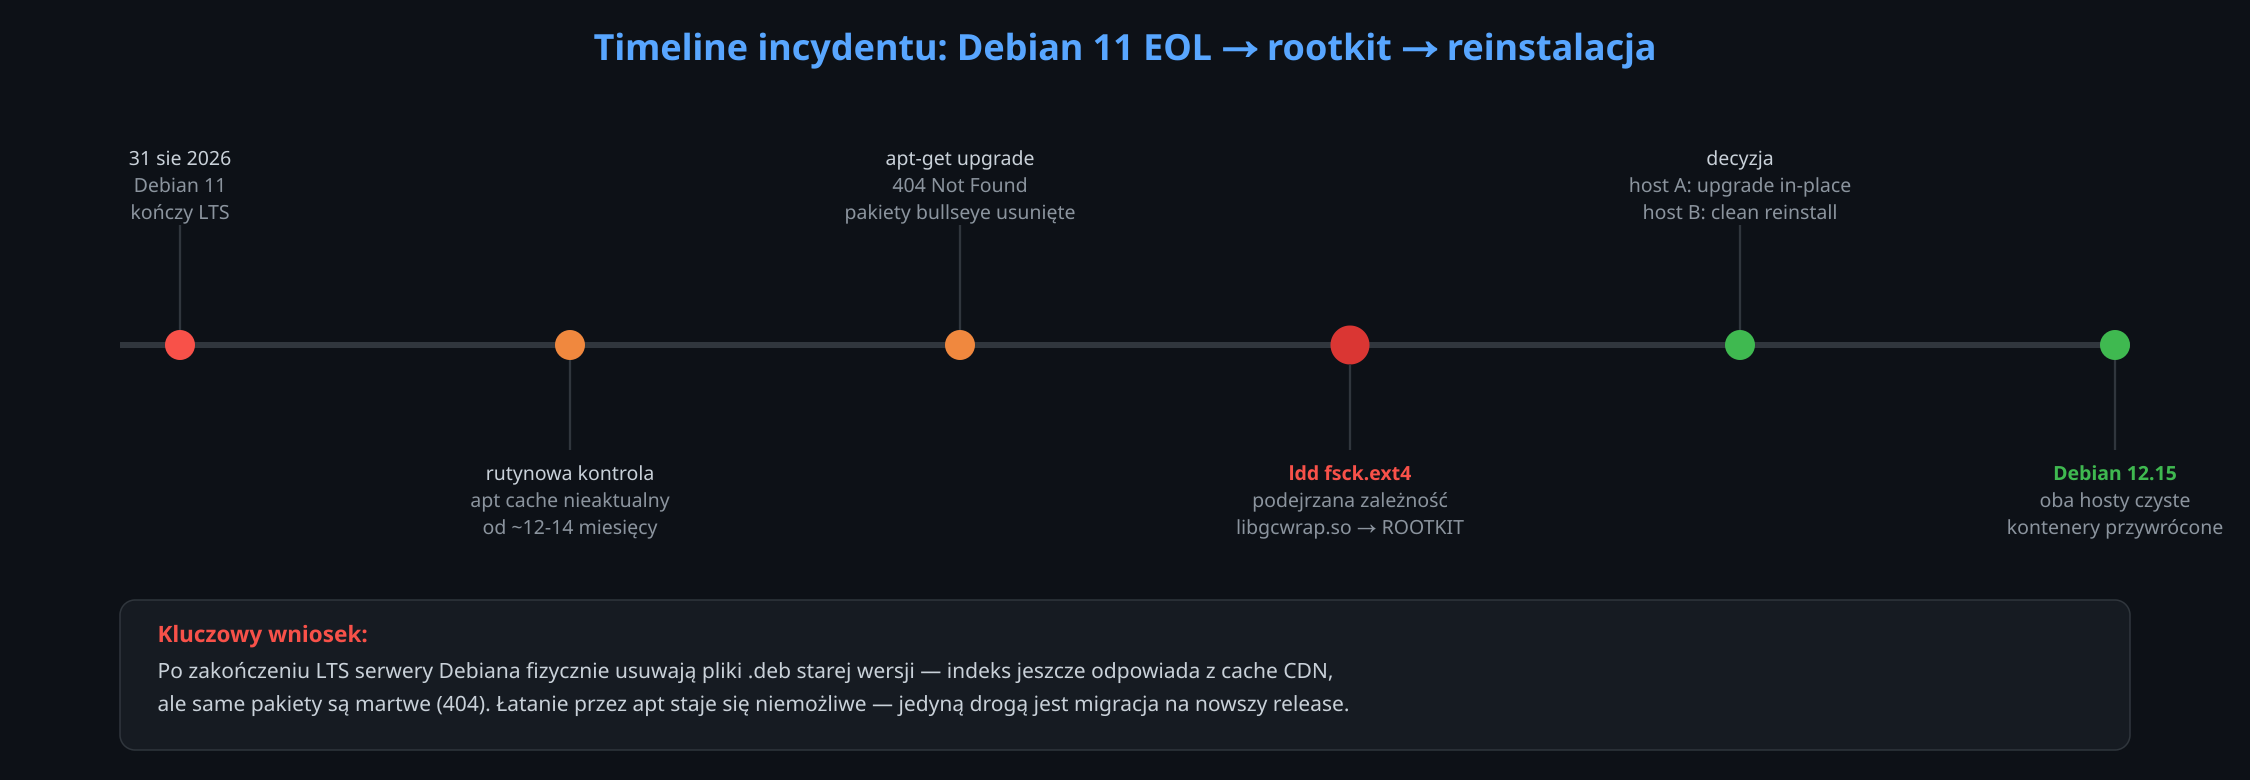
Poniżej cały przebieg, z dokładnymi komendami.
1. Punkt wyjścia: rutynowa kontrola aktualizacji
Dwa serwery produkcyjne (nazwiemy je Host A i Host B — oba to hosty Docker pod Portainer, w dwóch różnych lokalizacjach firmy) miały od dawna nie sprawdzaną listę aktualizacji. Pierwszy krok to zwykła diagnostyka przez SSH:
# Wersja systemu i podstawowe info
cat /etc/debian_version
uname -a
uptime

# Lista dostępnych aktualizacji (bez zmian w systemie)
sudo apt list --upgradable
Wynik na obu hostach:
11.11
...
Linux <host> 5.10.0-35-amd64 #1 SMP Debian 5.10.237-1 (2025-05-19) x86_64 GNU/Linux
Czyli Debian 11.11 „bullseye”, kernel z maja 2025. Sprawdzenie dat ostatniego apt-get update na obu hostach (stat -c %y /var/lib/apt/lists/) pokazało 12–14 miesięcy bez odświeżenia cache pakietów. To był pierwszy sygnał ostrzegawczy.
2. Problem: Debian 11 skończył LTS, a apt o tym „nie wie”
Szybkie sprawdzenie w dokumentacji Debiana:
> Debian 11 „bullseye” zakończył Long Term Support 31 sierpnia 2026 — pięć lat po pierwszym wydaniu z 2021 roku. Od tego dnia nie ma już żadnych aktualizacji bezpieczeństwa.
To był listopad 2026 — czyli oba serwery stały na systemie bez wsparcia bezpieczeństwa od ponad dwóch miesięcy, i to po roku bez żadnych łatek wcześniej.
Normalna reakcja — po prostu zaktualizować pakiety:
sudo apt-get update
sudo apt-get upgrade
Efekt na Hoście A:
Pobieranie:1 http://security.debian.org/debian-security bullseye-security InRelease [27,1 kB]
Pobrano 1 131 kB w 1s
Czytanie list pakietów... Gotowe

Err:1 http://security.debian.org/debian-security bullseye-security/main amd64 bind9-dnsutils 1:9.16.50-1~deb11u6
  404  Not Found
...
E: Nie można pobrać niektórych plików archiwów, może spróbuj uruchomić apt-get update
Kluczowa pułapka, o której warto pamiętać: po zakończeniu LTS serwery Debiana usuwają fizyczne pliki .deb starej wersji z CDN, ale indeks metadanych (listę pakietów) jeszcze jakiś czas serwują z cache — więc apt update i apt list --upgradable działają normalnie i pokazują dziesiątki pakietów „do aktualizacji”, a próba realnego ściągnięcia ich kończy się masowym 404. To wygląda jak problem sieciowy, ale jest to permanentny, zamierzony stan — łatanie przez apt na starym release jest po prostu już niemożliwe.
Wniosek: nie ma drogi pośredniej. Jedyną opcją jest migracja na nowszy release (Debian 12 „bookworm”, wsparcie do czerwca 2028, albo 13 „trixie”).
3. Przygotowanie: backup przed jakąkolwiek operacją
Zanim ruszyć z migracją, pełny backup danych kontenerów Dockera — to jedyny punkt powrotu, gdyby coś poszło źle:
# Na serwerze zdalnym: spakuj cały katalog danych Dockera
sudo tar czf /tmp/backup/varlibdocker.tar.gz /var/lib/docker

# Ściągnięcie lokalnie przez scp
scp -P <port> -i ~/.ssh/deploy_key user@<host>:/tmp/backup/varlibdocker.tar.gz ./backup/

# Weryfikacja sumy kontrolnej po obu stronach — MUSZĄ się zgadzać
md5sum ./backup/varlibdocker.tar.gz
ssh -p <port> -i ~/.ssh/deploy_key user@<host> "md5sum /tmp/backup/varlibdocker.tar.gz"
Dodatkowo — zapisanie pełnej konfiguracji każdego działającego kontenera (obraz, zmienne środowiskowe, bindy wolumenów, mapowanie portów), żeby w razie potrzeby odtworzyć je 1:1 bez Portainera:
docker inspect <nazwa_kontenera> > inspect-<nazwa_kontenera>.jsonTo się później okazało kluczowe dla Hosta B.
4. Host A: migracja w miejscu (apt-get, bez reinstalacji)
Host A nie wykazywał żadnych oznak kompromitacji, więc dla niego wybrano bezpieczniejszą, mniej ryzykowną ścieżkę — upgrade dystrybucji w miejscu, krok po kroku, bez przeskakiwania etapów:
Krok 1 — zmiana źródeł pakietów
# Backup starego sources.list
sudo cp /etc/apt/sources.list /etc/apt/sources.list.bullseye-bak

# Nowe źródła: bookworm (Debian 12)
sudo tee /etc/apt/sources.list <<'EOF'
deb http://deb.debian.org/debian/ bookworm main
deb-src http://deb.debian.org/debian/ bookworm main
deb http://security.debian.org/debian-security bookworm-security main
deb-src http://security.debian.org/debian-security bookworm-security main
deb http://deb.debian.org/debian/ bookworm-updates main
deb-src http://deb.debian.org/debian/ bookworm-updates main
EOF
Krok 2 — aktualizacja pakietów, najpierw „łagodna”
sudo apt-get update

# upgrade (bez zmiany zależności) PRZED full-upgrade — mniej ryzykowne,
# wychwytuje konflikty zanim zrobi się duży skok wersji
sudo apt-get -y \
  -o Dpkg::Options::=--force-confdef \
  -o Dpkg::Options::=--force-confold \
  upgrade
Flagi --force-confdef --force-confold mówią dpkg, żeby przy konfliktach plików konfiguracyjnych zachował lokalną wersję zamiast przerywać proces pytaniem interaktywnym — niezbędne przy zdalnej, nienadzorowanej sesji SSH.
Krok 3 — właściwy skok wersji
sudo apt-get -y \
  -o Dpkg::Options::=--force-confdef \
  -o Dpkg::Options::=--force-confold \
  full-upgrade

sudo reboot
full-upgrade (odpowiednik starego dist-upgrade) potrafi instalować i usuwać pakiety, żeby rozwiązać zmienione zależności między wydaniami — stąd robi się go osobno, po tym jak podstawowe pakiety są już zaktualizowane.
Krok 4 — weryfikacja po restarcie
cat /etc/debian_version        # -> 12.15
uname -r                       # -> 6.1.0-...
docker ps                      # kontenery wstały, Portainer agent łączy się
Jedna praktyczna pułapka napotkana w trakcie: proces apt/dpkg na jednym etapie się zawiesił (czekał w tle na coś, co nigdy nie przyszło przy nienadzorowanej sesji). Trzeba było ręcznie dobić zawieszone procesy po stronie zdalnej i powtórzyć krok w pełni nieinteraktywnie:
# znajdź i zabij zawieszone procesy apt/dpkg
sudo killall -9 apt apt-get dpkg 2>/dev/null
sudo dpkg --configure -a
Cały upgrade zajął ok. 45 minut, zero utraty danych, kontenery (Portainer, agent i usługi aplikacyjne) wstały bez interwencji po restarcie.
5. Host B: ta sama diagnostyka, inne odkrycie
Na drugim hoście, w trakcie analogicznej diagnostyki (tym razem dokładniejszej, bo coś „pachniało” nie tak), rzucił się w oczy nietypowy wynik:
ldd /usr/sbin/e2fsck...
libgcwrap.so => /lib/libgcwrap.so (0x00007f...)fsck.ext4 nie ma i nigdy nie miał zależności o nazwie libgcwrap.so — to nie jest standardowa biblioteka e2fsprogs. Pierwsze podejrzenie: klasyczny rootkit przez /etc/ld.so.preload.
cat /etc/ld.so.preloadcat: /etc/ld.so.preload: Nie ma takiego pliku ani kataloguPlik nie istniał — czyli to nie standardowa technika LD_PRELOAD. Sprawdzenie samego pliku biblioteki:
ls -la /lib/libgcwrap.so /usr/lib/libgcwrap.so-rwxr-sr-x 1 root root 80800 10-31 21:11 /lib/libgcwrap.so
-rwxr-sr-x 1 root root 80800 10-31 21:11 /usr/lib/libgcwrap.soPlik istniał, 80 KB, setgid, z datą modyfikacji sprzed czterech dni — zupełnie nie przypominał niczego z oficjalnego Debiana. Kolejny krok — sprawdzenie, jak ta biblioteka trafiła na listę zależności binarki, bez pliku ld.so.preload:
readelf -d /usr/sbin/e2fsck | grep NEEDEDTo pokazało, że wpis libgcwrap.so był wstrzyknięty bezpośrednio do nagłówka ELF binarki jako dodatkowa zależność NEEDED — czyli ktoś (lub coś) ręcznie zmodyfikował skompilowany plik /usr/sbin/e2fsck tak, by przy każdym jego uruchomieniu automatycznie doładowywał tę bibliotekę. To znacznie trudniejsza do wykrycia technika niż standardowy /etc/ld.so.preload, bo nie da się jej znaleźć, sprawdzając typowe „znane miejsca” rootkitów — trzeba przeglądać same binarki.
Dodatkowa analiza (nieudana, bo plik już nie istniał w drugiej lokalizacji sprawdzanej później — ślad po części usunięty/przeniesiony) pokazała też, że druga kopia referencji z /usr/lib/ prowadziła do nieistniejącego już pliku — spójne z aktywnym, ale niestabilnym/”ruchomym” mechanizmem perzystencji.
Prawdopodobny wektor ataku: 15 miesięcy bez żadnych łatek bezpieczeństwa + wystawiony publicznie sshd + kontenery typu „passive income” (aplikacje udostępniające pasmo/moc obliczeniową w zamian za drobne wypłaty) — klasyczna kombinacja ryzyka dla małego, niedopatrzonego serwera.
6. Decyzja: reinstalacja, nie naprawa
Z rootkitem na poziomie userland (zmodyfikowane binarki systemowe) nie da się zaufać niczemu na hoście — nawet jeśli usunie się jeden znaleziony plik, nie ma gwarancji, że to jedyny ślad, a dalsze grzebanie w zainfekowanym systemie przez SSH tylko zwiększa ryzyko, że coś przeoczymy. Jedyna rozsądna droga: pełna, czysta reinstalacja systemu operacyjnego, z zachowaniem tylko tego, co da się zweryfikować z zewnątrz (konfiguracja kontenerów, nie pliki binarne hosta).

Krok 1 — zabezpieczenie konfiguracji kontenerów
Przed wymazaniem dysku, docker inspect dla każdego działającego kontenera (Portainer, agent, usługi aplikacyjne), żeby móc je odtworzyć na nowym systemie bez utraty ustawień:
for c in $(docker ps -aq); do
  docker inspect "$c" > "/var/backups/migration/inspect-$(docker inspect -f '{{.Name}}' "$c" | tr -d /).json"
done
Pliki ściągnięte lokalnie przez scp, zweryfikowane i zapisane poza zasięgiem zainfekowanego hosta.
Krok 2 — zdalna reinstalacja przez netinstall z GRUB-a, bez fizycznego dostępu
Serwer był dostępny tylko przez SSH (brak lokalnego IPMI/iDRAC), więc reinstalację trzeba było zrobić całkowicie zdalnie, metodą „boot przez GRUB w instalator netinstall, reszta nienadzorowana przez preseed„:
- Zdalne pobranie obrazu netinstall Debiana 12 i rozpakowanie jądra + initrd instalatora w katalogu
/boot, obok istniejącego systemu. - Dopisanie tymczasowego wpisu w GRUB-ie wskazującego na nowe jądro/initrd instalatora, z parametrami
auto=true priority=critical url=. - Przygotowanie pliku
preseed.cfg— definiuje całą instalację bez pytań: partycjonowanie, hostname, konto użytkownika, pakiety bazowe, orazlate_command, który po zakończeniu instalacji automatycznie wgrywa klucz publiczny SSH do~/.ssh/authorized_keysna nowym systemie — dzięki temu logowanie po reinstalacji działa od razu, bez hasła. rebootdo nowego wpisu GRUB i czekanie, aż instalator dokończy pracę automatycznie.
Fragment kluczowej części preseed.cfg (uogólniony, bez adresów):
d-i partman-auto/method string regular
d-i partman-auto/choose_recipe select atomic
d-i partman-partitioning/confirm_write_new_label boolean true
d-i partman/confirm_write_new_label boolean true
d-i partman/choose_partition select finish
d-i partman/confirm boolean true

d-i netcfg/get_hostname string <hostname>
d-i netcfg/get_domain string local

d-i passwd/user-fullname string user
d-i passwd/username string user
d-i passwd/user-password-crypted password <hash>

tasksel tasksel/first multiselect standard, ssh-server

d-i preseed/late_command string \
  in-target mkdir -p /home/user/.ssh && \
  in-target sh -c 'echo "<klucz_publiczny>" >> /home/user/.ssh/authorized_keys' && \
  in-target chown -R user:user /home/user/.ssh && \
  in-target chmod 700 /home/user/.ssh && \
  in-target chmod 600 /home/user/.ssh/authorized_keys
Krok 3 — pierwsza próba zawiodła: DHCP vs. statyczne IP
Pierwszy preseed zakładał, że instalator skonfiguruje sieć przez DHCP. Problem: ten host miał normalnie statyczny adres IP, a instalator w trybie priority=critical zatrzymuje się i czeka na ręczną odpowiedź, gdy trafi na pytanie o konfigurację sieci, które preseed nie pokrywa w pełni automatycznie. Efekt: po 25 minutach od restartu host był całkowicie nieosiągalny w sieci — ani przez stary adres, ani nigdzie w skanowanej podsieci.
Diagnoza: instalator żyje, ale stoi w miejscu na czarnym ekranie konsoli, czekając na input, którego nikt (zdalnie, bez dostępu do konsoli) nie mógł podać.
Krok 4 — druga próba: preseed ze statycznym IP od razu
Poprawiony plik preseed.cfg z pełną, jawną konfiguracją sieci (bez polegania na DHCP):
d-i netcfg/disable_autoconfig boolean true
d-i netcfg/get_ipaddress string <statyczne_ip>
d-i netcfg/get_netmask string 255.255.255.0
d-i netcfg/get_gateway string <gateway>
d-i netcfg/get_nameservers string <gateway>
d-i netcfg/confirm_static boolean true
Tym razem instalacja przeszła w pełni automatycznie: świeży Debian 12.15, kernel 6.1.0-50, klucz SSH działający od razu dzięki late_command. System chwilowo wstał pod innym adresem DHCP (dlatego wcześniejsze sprawdzanie starego adresu nic nie wykazywało), po czym ręcznie przełączony z powrotem na stały adres i restart interfejsu sieciowego.
Krok 5 — odtworzenie kontenerów z zapisanej konfiguracji
Na czystym systemie, z zainstalowanym Dockerem z oficjalnego repozytorium (get.docker.com, nie z repo Debiana — nowsza i aktualniejsza wersja), kontenery odtworzone ręcznie na podstawie zapisanych wcześniej plików inspect-*.json (obraz, zmienne środowiskowe, porty, wolumeny) — bez Portainera jako punktu odtworzenia, bo samemu Portainerowi też nie ufano po incydencie:
# przykład odtworzenia kontenera na podstawie zapisanej konfiguracji
docker run -d \
  --name <nazwa> \
  --restart unless-stopped \
  -e <ZMIENNA>=<wartość_z_backupu> \
  <obraz:tag>
Portainer i jego agent zainstalowane od zera (nowa instancja, nowe hasła), kontenery aplikacyjne podłączone z zachowaniem tych samych tokenów/ID urządzeń, co pozwoliło im „rozpoznać się” u dostawców usług bez ponownej rejestracji.
7. Wnioski
- Koniec LTS to nie kosmetyka. Po tej dacie
apt upgradeprzestaje fizycznie działać (404), nawet jeśliapt list --upgradablejeszcze „widzi” pakiety do zainstalowania. To silny sygnał, że system jest od tego momentu bez żadnej siatki bezpieczeństwa. - Stary, niełatany system z wystawionym SSH to tylko kwestia czasu. 14+ miesięcy bez aktualizacji bezpieczeństwa na serwerze dostępnym z sieci to realne ryzyko kompromitacji, nie teoretyczne.
- Rootkit na poziomie userland = zero zaufania do hosta. Modyfikacja binarek systemowych (wstrzyknięcie zależności
NEEDEDw nagłówku ELF) jest trudniejsza do wykrycia niż klasyczny/etc/ld.so.preloadi wystarczający powód, by zamiast „czyszczenia” wybrać pełną reinstalację. - Zdalna reinstalacja bez fizycznego dostępu jest możliwa (netinstall z GRUB-a +
preseed), ale wymaga jawnej konfiguracji sieci w preseedzie, jeśli host nie korzysta z DHCP — inaczej instalator zawiesi się bezgłośnie na pytaniu, którego nikt zdalnie nie może zobaczyć. - Backup konfiguracji kontenerów (
docker inspect) przed jakąkolwiek destrukcyjną operacją pozwolił odtworzyć całe środowisko aplikacyjne na czystym systemie bez utraty ustawień — mimo że dane samego hosta zostały całkowicie wymazane.
Adresy IP, nazwy hostów i hasła użyte w oryginalnym incydencie zostały usunięte/zanonimizowane w tym opisie.